レコード一括作成・更新
概要
APIを使用して複数レコードを一括作成または一括更新します。
- 指定したキー項目に一致するレコードがある場合:該当レコードを更新
- 一致するレコードがない場合:新規作成1
- 指定したキー項目の値がNULLの場合:レコードを新規作成
- キー項目が無い場合:全てのレコードを新規作成
このAPIでは、処理が正常に終了した時に通知できます。通知するには、通知タイミングの"インポート後"を有効にしておきます。
注意事項
- レコード単位で処理をおこない途中がエラーが発生した場合は以降の処理は中止されます。
制限事項
- 対象のサイトに「作成」および「更新」権限が必要です。
- Wikiでは使用できません。
- パラメータGeneral.jsonの「BulkUpsertMax」で設定した値を超えたレコードがあった場合は処理を行いません。
事前準備
APIの操作を行う前にAPIキーの作成を実施してください。
リクエスト
下記のリクエスト形式で、JSONデータを送信します。
| 設定項目 | 値 |
|---|---|
| HTTPメソッド | POST |
| Content-Type | application/json |
| 文字コード | UTF-8 |
| URL | http://{サーバ名}/api/items/{サイトID}/bulkupsert2 |
| Body | 以下のJSONデータを参考のこと。詳細は「JSONデータレイアウト:共通」を参照してください。 |
JSON
{
    "ApiVersion": "1.1",
    "ApiKey": "345yuAjA6789dA09d8uj6...",
    "SsCache": true,
    "Keys": [
        "ClassA"
    ],
    "KeyNotFoundCreate": true,
    "Data": [
        {
            "Title": "新機能XXを開発する1",
            "ClassHash": {
                "ClassA": "RC0001"
            },
            "VerUp": true
        },
        {
            "Title": "新機能XXを開発する2",
            "ClassHash": {
                "ClassA": "RC0002"
            },
            "VerUp": true
        }
    ]
}
| カラム | 設定内容 |
|---|---|
| Keys | キーとなる項目を指定。複数の項目を指定可能。(省略時:全てのレコードの新規作成) |
| KeyNotFoundCreate | キーと一致するレコードが無い場合に新規作成します。(省略時:true) |
| Data | レコードの配列 |
指定するキー項目について
指定したキー項目をもとにAPIによるレコード作成・更新(upsert)を行います。キー項目の指定は以下のパラメータで指定します。
キー項目の指定が無い場合は全てのレコードの新規作成を行います。
Keysに指定した項目の値がNULLの場合、キー項目としての比較はされず、レコードが新規作成されます。
詳細につきましては、下記の (a)キーが無い場合、(b)単一キーの場合、(c)複合キーの場合 を参照してください。
APIによる画像の挿入について
BodyにImageHashを指定することで内容、コメント、説明項目に画像を挿入することが可能です。
更新系のAPI(update/upsert)で本機能によるレコード更新を行う場合、既存レコードの該当項目は内容、説明項目では上書き、コメント項目では追加となります。また、更新系のAPIで内容、説明項目に登録する文字列を指定するBodyやDescriptionHashを省略した状態でImageHashのみを指定すると、上書きではなく追加となります。
ImageHashの指定方法
| 第1階層 | 第2階層 | 第3階層 | 説明 | 例 |
|---|---|---|---|---|
| ImageHash | Body | HeadNewLine | 画像を挿入する際の先頭の改行有無をtrue/falseで指定します。省略した場合は改行しません。 | true |
| EndNewLine | 画像を挿入する際の末尾の改行有無をtrue/falseで指定します。省略した場合は改行しません。 | true | ||
| Position | 同じリクエスト内で対象項目に文字列を設定する場合に画像を何文字目に挿入するかを数値で指定します。-1を指定した場合および省略した場合は末尾に挿入されます。 | 3 | ||
| Alt | alt属性(Webブラウザで画像が表示できないときに、画像の代わりに表示されるテキスト)に挿入する文字列を指定します。省略した場合は「image」が設定されます。 | hayato | ||
| Extension | Binariesテーブルに登録するファイル拡張子を指定します。省略した場合は「.png」が設定されます。 | .jpeg | ||
| Base64 | Base64エンコードした画像のバイナリデータを文字列で指定します。ImageHashを指定する場合、省略はできません。 | iVBORw0KG…(以下略) | ||
| Comments | (同上) | (同上) | - | |
| DescriptionA | (同上) | (同上) | - | |
| DescriptionB | (同上) | (同上) | - |
APIによるプロセスの実行について
リクエストデータに、プロセスIDを指定し、プロセスを実行することが可能です。
事前準備
事前にプロセスを設定してください。
制限事項
APIからプロセスを実行する場合、プロセスで設定した入力検証は適用されません。
プロセスの指定方法
ProcessId または ProcessIds のいずれか一方を設定してください。
両方が設定された場合は、ProcessIds が有効です。
ProcessIds を指定した場合、リストで指定された複数のプロセスIDは、事前に設定されているプロセス一覧の表示順に従って実行されます。
| 設定項目 | 説明 | 例 |
|---|---|---|
| ProcessId | プロセスのIDを指定します。 | 1 |
| ProcessIds | 複数のプロセスのIDを指定します。 | [1,2,3] |
(a)キーが無い場合
Keys パラメータが無い場合には、全てのレコードを新規作成します。
KeyNotFoundCreate パラメータの値は無視されます。
JSON
{
    "ApiVersion": 1.1,
    "ApiKey": "145Afa9AF2A10SafaA21641...",
    "SsCache": true,
    "Data": [
        {
            "Title": "新機能XXを開発する1",
            "Body": "ボディ1",
            "CompletionTime": "2018/3/31",
            "ProcessId": 1,
            "ClassHash": {
                "ClassA": "RC0001",
                "ClassB": "分類2"
            },
            "NumHash": {
                "NumA": 100
            },
            "DateHash": {
                "DateA": "2019/01/01"
            },
            "DescriptionHash": {
                "DescriptionA": "説明1"
            },
            "CheckHash": {
                "CheckA": false
            },
            "ImageHash": {
                "Body": {
                    "HeadNewLine": true,
                    "EndNewLine": true,
                    "Position": 3,
                    "Alt": "imageBody",
                    "Extension": ".jpeg",
                    "Base64": "iVBORw0KG..."
                },
                "DescriptionA": {
                    "HeadNewLine": true,
                    "EndNewLine": true,
                    "Position": 3,
                    "Alt": "imageDescriptionA",
                    "Extension": ".jpeg",
                    "Base64": "iVBORw0KG..."
                }
            }
        },
        {
            "Title": "新機能XXを開発する2",
            "Body": "ボディ2",
            "CompletionTime": "2018/3/31",
            "ProcessId": 1,
            "ClassHash": {
                "ClassA": "RC0002",
                "ClassB": "分類3"
            },
            "NumHash": {
                "NumA": 100
            },
            "DateHash": {
                "DateA": "2019/01/01"
            },
            "DescriptionHash": {
                "DescriptionA": "説明2"
            },
            "CheckHash": {
                "CheckA": false
            }
        }
    ]
}
(b)単一キーの場合
Keys パラメータにキーとなる項目の項目名を配列形式で設定します。Keys に指定した項目について、パラメータで指定した値と一致するレコードを検索します。
下記の例では、1つ目のレコード「ClassA」項目の値が "RC0001" のレコードを検索します。 2つ目のレコード「ClassA」項目の値が "RC0002"のレコードを検索します。
レコードを検索した結果に応じて下記の処理が実行されます。
- 対象のレコードが存在しなかった場合: レコードが新規作成されます。ただしKeyNotFoundCreateパラメータがfalseの場合は新規作成されません。
- 対象のレコードが1件存在した場合: そのレコードが更新されます。
- 対象のレコードが複数件存在した場合: レコードの作成・更新は行われず、エラーレスポンスが返却されます。
JSON
{
    "ApiVersion": 1.1,
    "ApiKey": "145Afa9AF2A10SafaA21641...",
    "SsCache": true,
    "Keys": [
        "ClassA"
    ],
    "KeyNotFoundCreate": true,
    "Data": [
        {
            "Title": "新機能XXを開発する1",
            "Body": "ボディ1",
            "CompletionTime": "2018/3/31",
            "ProcessId": 1,
            "ClassHash": {
                "ClassA": "RC0001",
                "ClassB": "分類2"
            },
            "NumHash": {
                "NumA": 100
            },
            "DateHash": {
                "DateA": "2019/01/01"
            },
            "DescriptionHash": {
                "DescriptionA": "説明1"
            },
            "CheckHash": {
                "CheckA": false
            },
            "ImageHash": {
                "Body": {
                    "HeadNewLine": true,
                    "EndNewLine": true,
                    "Position": 3,
                    "Alt": "imageBody",
                    "Extension": ".jpeg",
                    "Base64": "iVBORw0KG..."
                },
                "DescriptionA": {
                    "HeadNewLine": true,
                    "EndNewLine": true,
                    "Position": 3,
                    "Alt": "imageDescriptionA",
                    "Extension": ".jpeg",
                    "Base64": "iVBORw0KG..."
                }
            }
        },
        {
            "Title": "新機能XXを開発する2",
            "Body": "ボディ2",
            "CompletionTime": "2018/3/31",
            "ProcessId": 1,
            "ClassHash": {
                "ClassA": "RC0002",
                "ClassB": "分類3"
            },
            "NumHash": {
                "NumA": 100
            },
            "DateHash": {
                "DateA": "2019/01/01"
            },
            "DescriptionHash": {
                "DescriptionA": "説明2"
            },
            "CheckHash": {
                "CheckA": false
            }
        }
    ]
}
(c)複合キーの場合
Keys パラメータに複数の項目名を設定した場合、Keys に指定したすべての項目について、パラメータで指定した値と一致するレコードを検索します。
下記の例では、1つ目のレコード「ClassA」項目の値が "RC0001" かつ、「ClassB」項目の値が "001" のレコードを検索します。 2つ目のレコード「ClassA」項目の値が "RC0001" かつ、「ClassB」項目の値が "002" のレコードを検索します。
- 対象のレコードが存在しなかった場合: レコードが新規作成されます。ただしKeyNotFoundCreateパラメータがfalseの場合は新規作成されません。
- 対象のレコードが1件存在した場合: そのレコードが更新されます。
- 対象のレコードが複数件存在した場合: レコードの作成・更新は行われず、エラーレスポンスが返却されます。
JSON
{
    "ApiVersion": 1.1,
    "ApiKey": "145Afa9AF2A10SafaA21641...",
    "SsCache": true,
    "Keys": [
        "ClassA",
        "ClassB"
    ],
    "KeyNotFoundCreate": true,
    "Data": [
        {
            "Title": "新機能XXを開発する1",
            "Body": "ボディ1",
            "CompletionTime": "2018/3/31",
            "ProcessId": 1,
            "ClassHash": {
                "ClassA": "RC0001",
                "ClassB": "001"
            },
            "NumHash": {
                "NumA": 100
            },
            "DateHash": {
                "DateA": "2019/01/01"
            },
            "DescriptionHash": {
                "DescriptionA": "説明1"
            },
            "CheckHash": {
                "CheckA": false
            },
            "ImageHash": {
                "Body": {
                    "HeadNewLine": true,
                    "EndNewLine": true,
                    "Position": 3,
                    "Alt": "imageBody",
                    "Extension": ".jpeg",
                    "Base64": "iVBORw0KG..."
                },
                "DescriptionA": {
                    "HeadNewLine": true,
                    "EndNewLine": true,
                    "Position": 3,
                    "Alt": "imageDescriptionA",
                    "Extension": ".jpeg",
                    "Base64": "iVBORw0KG..."
                }
            }
        },
        {
            "Title": "新機能XXを開発する2",
            "Body": "ボディ2",
            "CompletionTime": "2018/3/31",
            "ProcessId": 1,
            "ClassHash": {
                "ClassA": "RC0001",
                "ClassB": "002"
            },
            "NumHash": {
                "NumA": 100
            },
            "DateHash": {
                "DateA": "2019/01/01"
            },
            "DescriptionHash": {
                "DescriptionA": "説明2"
            },
            "CheckHash": {
                "CheckA": false
            }
        }
    ]
}
レスポンス
下記の形式のJSONデータが返却されます。
レコードが新規作成された場合
JSON
{
    "Id": 12345,
    "StatusCode": 200,
    "LimitPerDate": 10000,
    "LimitRemaining": 9994,
    "Message": "記録テーブル: 1 件追加し、0 件更新しました。"
}
レコードが更新された場合
JSON
{
    "Id": 12345,
    "StatusCode": 200,
    "LimitPerDate": 10000,
    "LimitRemaining": 9994,
    "Message": "記録テーブル: 0 件追加し、1 件更新しました。"
}
サイト単位でエラーとなった場合
JSON
レコード単位でエラーとなった場合
JSON
{
    "Id": 12345,
    "StatusCode": 500,
    "Message": "記録テーブル:エラーが発生しました。0 件追加し、0 件更新。\nIndex:1(ClassA=RC00011)\nエラー内容:条件に一致するレコードが複数存在します。"
}
パラメータGeneral.jsonの「BulkUpsertMax」で設定した値を超えたレコードがあった場合
JSON
サンプルコード
コード内の【 ... 】 は適宜修正してください。
1. ファイル名からUpsertキーを取得、キーに合致するレコードにファイルを添付する
任意のフォルダに格納されたファイルを読み取り、ファイル名よりUpsertのキー情報を取得しbulkUpsertを実行、当該ファイルを添付します。
実務での使いどころ
スキャンした契約書や図面などを、ファイル名に付けた管理番号(KC001 など)で、該当する案件のレコードへまとめて添付したいときに使えます。管理番号のレコードが無ければ新しく作るので、紙の書類の電子化やファイルサーバからの移行で、1 件ずつ添付する手間を省けます。件数が多いときは、1 回のリクエストでまとめて送れる一括 Upsert のほうが、リクエストの回数を減らせます。
本サンプルでは、以下のようなファイル名基準とし、”KC”+数字をキー項目として判定します。
KC001_XXXXX.txt
→"KC001"がUpsertキー
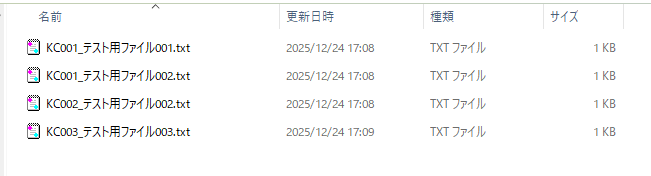
実行前
このようなファイルを用意
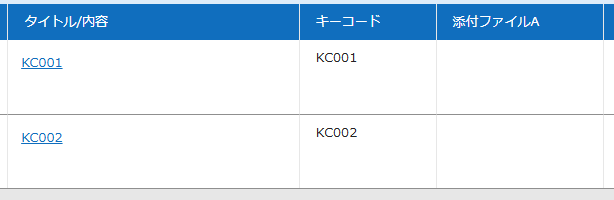
登録対象のテーブルの状態、KC001、KC002のレコードが存在
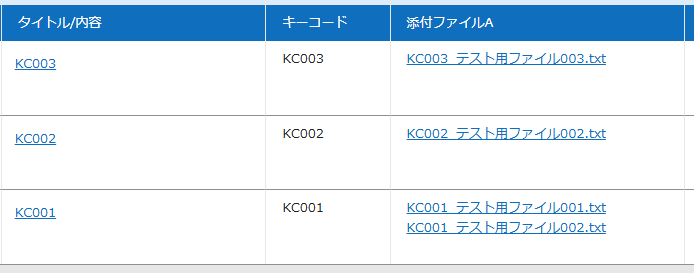
実行後
ファイル名にしたがい、ファイル添付・レコード作成
Python(api_record_bulkupsert_p1.py)
# WebサイトやAPIと通信するためのライブラリ
import requests

# 画像をBase64化するためのライブラリ
import base64

# JSON操作のためのライブラリ
import json

# ファイル操作や正規表現のためのライブラリ
import mimetypes

# その他標準ライブラリ
import re

# データ構造操作のためのライブラリ
from collections import defaultdict

# ファイルパス操作のためのライブラリ
from pathlib import Path

# 接続先URL
BASE_URL = "【URL】"
# サイトID
SITE_ID = 【サイトID】
# APIキー
API_KEY = "【APIキー】"
# 対象フォルダ
TARGET_FOLDER = r"【パス】"

# キーコード抽出用正規表現
KEY_REGEX = re.compile(r"^KC\d+$")

# bulkupsert のキー項目
KEYS = ["ClassA"]

# KeyNotFoundCreate=true なら、キー未存在は新規作成
KEY_NOT_FOUND_CREATE = True

# 1回で投げる Data 件数(BulkUpsertMax を超えない範囲で)
BULK_UPSERT_MAX = 10000

def extract_keycode(filename: str) -> str | None:
    # KC001_FILENAME.txt -> KC001 / ルール外は None
    if "_" not in filename:
        return None
    head = filename.split("_", 1)[0].strip()
    if not head or not KEY_REGEX.match(head):
        return None
    return head

def file_to_attachment_obj(path: Path) -> dict:
    # Pleasanter AttachmentsA の要素を作る
    ctype, _ = mimetypes.guess_type(path.name)
    if not ctype:
        ctype = "application/octet-stream"
    b64 = base64.b64encode(path.read_bytes()).decode("ascii")
    return {
        "ContentType": ctype,
        "Name": path.name,
        "Base64": b64,
    }

def get_existing_keycodes(session: requests.Session) -> set[str]:
    # テーブルにすでにあるキーコード(ClassA)を、1回分ずつ取得してまとめる
    url = f"{BASE_URL}/api/items/{SITE_ID}/get"
    keycodes: set[str] = set()
    offset = 0
    while True:
        payload = {"ApiVersion": 1.1, "ApiKey": API_KEY, "Offset": offset}
        r = session.post(url, data=json.dumps(payload))
        if not r.ok:
            raise RuntimeError(f"レコード取得失敗 HTTP {r.status_code}\n{r.text}")
        response = r.json()["Response"]
        rows = response.get("Data", [])
        for row in rows:
            keycode = (row.get("ClassHash") or {}).get("ClassA")
            if keycode:
                keycodes.add(keycode)
        offset += len(rows)
        if not rows or offset >= response.get("TotalCount", 0):
            return keycodes

def chunked(lst, n):
    for i in range(0, len(lst), n):
        yield lst[i : i + n]

def bulkupsert(session: requests.Session, data_rows: list[dict]) -> dict:
    url = f"{BASE_URL}/api/items/{SITE_ID}/bulkupsert"
    payload = {
        "ApiVersion": "1.1",
        "ApiKey": API_KEY,
        "Keys": KEYS,
        "KeyNotFoundCreate": KEY_NOT_FOUND_CREATE,
        "Data": data_rows,
    }
    r = session.post(url, data=json.dumps(payload))
    if not r.ok:
        raise RuntimeError(f"HTTP {r.status_code}\n{r.text}")
    return r.json()

def main():
    folder = Path(TARGET_FOLDER)
    if not folder.is_dir():
        raise SystemExit(f"フォルダが見つかりません: {folder}")

    # キーコードごとにファイルをまとめる(同じKCに複数ファイルがある想定)
    grouped: dict[str, list[Path]] = defaultdict(list)

    for p in folder.iterdir():
        if not p.is_file():
            continue
        keycode = extract_keycode(p.name)
        if not keycode:
            # ルール不一致は処理対象外
            continue
        grouped[keycode].append(p)

    if not grouped:
        print("処理対象ファイルなし(命名規則に一致するファイルがありません)")
        return

    session = requests.Session()
    session.headers.update({"Content-Type": "application/json"})

    # すでにあるキーコードを先に調べ、新しく作るレコードかどうかを判定する
    existing = get_existing_keycodes(session)

    # bulkupsert の Data を組み立て(キーごとに 1レコード)
    # ※キー項目ClassAに keycode を入れる想定
    rows: list[dict] = []
    for keycode, paths in grouped.items():
        attachments = [file_to_attachment_obj(p) for p in paths]
        row = {
            "ClassHash": {
                "ClassA": keycode,
            },
            # 添付Aに登録
            "AttachmentsHash": {"AttachmentsA": attachments},
        }
        # 新しく作るレコードだけ、タイトルにキーコードを入れる(既存のレコードのタイトルは変えない)
        if keycode not in existing:
            row["Title"] = keycode
        rows.append(row)

    # BulkUpsertMax を超えないように分割送信
    for part in chunked(rows, BULK_UPSERT_MAX):
        res = bulkupsert(session, part)
        print(res)

    print(
        f"完了: 対象キー={len(grouped)}件 / 対象ファイル={sum(len(v) for v in grouped.values())}件"
    )

if __name__ == "__main__":
    main()
実行
実行結果
BulkUpsertを使うサンプル「未ログインユーザを棚卸表へ抽出する」は、「ユーザ取得(選択)」のサンプルコードにあります。
対応バージョン
| 対応バージョン | 内容 |
|---|---|
| 1.4.6.0以降 | 機能追加 |
| 1.5.6.0 以降 | VerUpを追加 |
エラー時の確認事項
・API使用時の注意点やエラーが発生する場合の確認事項
・FAQ:変更後の設定ファイルやAPIリクエスト(JSON形式)が正しく認識されない場合の確認事項